ข้ามไปยังเนื้อหา
KoishiAI
EN

บทความในหมวด

#benchmark

Two scientists wearing lab coats and goggles analyze data on a computer in a modern laboratory.
ai-research ai-agents open-source

เอไอเอเจนต์ในงาน ML ทางวิทยาศาสตร์: ด้านวิศวกรรมเทียบกับความเข้าใจเชิงลึก

งานวิจัยใหม่ชี้ให้เห็นว่าเอไอเอเจนต์มีความเชี่ยวชาญด้านวิศวกรรม ML แต่ขาดความเข้าใจเชิงลึกในโดเมนสำหรับการค้นพบทางวิทยาศาสตร์ ตามผลการศึกษาจากเกณฑ์มาตรฐาน Agent4Sci

· 22 นาทีในการอ่าน
High-tech robots assembling a car in a modern factory setting, showcasing automation.
ai-robotics gemini benchmark

Gemini 4 Argon เทียบคู่แข่ง: มีการเปลี่ยนแปลงอะไรบ้างและต้นทุนเท่าไร

Gemini 4 Argon ของ Google DeepMind สำหรับหุ่นยนต์อ้างว่าทำผลงานได้ดีที่สุดในเกณฑ์การทดสอบเหตุผลทางกายภาพและการควบคุมหุ่นยนต์ในโลกจริง แต่คะแนนที่ตรวจสอบได้แตกต่างจากรายงานเบื้องต้น โมเดลนี้เปิดตัวในราคา 2 ดอลลาร์ต่อล้านโทเค็นนำเข้า มุ่งเน้นไปที่นักพัฒนาหุ่นยนต์ระดับองค์กร

· 26 นาทีในการอ่าน
A close-up of a prosthetic hand interacting with a smartphone showcasing futuristic technology.
ai-agents benchmark mobile-ai

เอไอเอเยนต์ยังทำได้ยากกับงานบนมือถือที่ซับซ้อน: เกณฑ์การประเมิน GMA ฉบับใหม่

เกณฑ์การประเมิน GMA ใหม่เผยให้เห็นว่าเอไอเอเยนต์ยังมีปัญหาในการจัดการงานบนมือถือที่ซับซ้อน พร้อมเจาะลึกสาเหตุที่โมเดลปัจจุบันยังทำงานได้ไม่สมบูรณ์ในสถานการณ์จริงและการจดจำบริบท

· 31 นาทีในการอ่าน
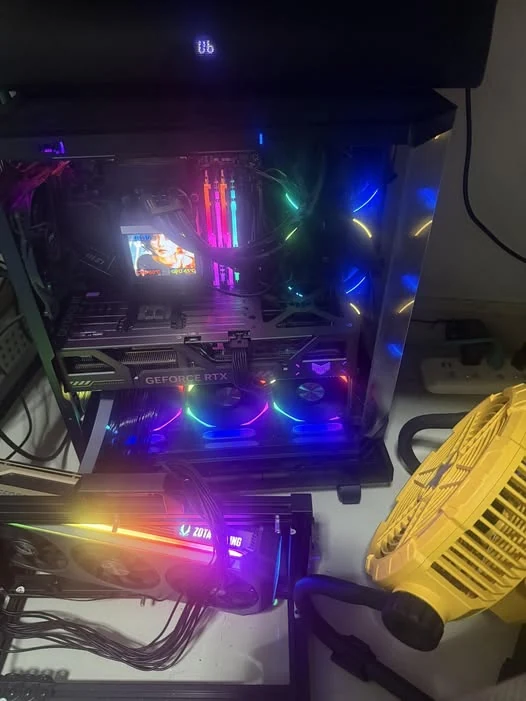
เครื่องทดสอบจริงของ KoishiAI — workstation แบบเปิดฝา ใส่ RTX 5090 (ด้านบน) และ Zotac RTX 5080 (ด้านล่าง) พร้อมไฟ RGB และพัดลมเสริมที่โต๊ะ ถ่ายในประเทศไทย
local-llm benchmark qwen3

ทดสอบ LLM ในเครื่องบน Dual-GPU 48 GB: รุ่นไหนใช้ได้จริงในปี 2026

เราทดสอบ Qwen3 27B, 32B, 35B-A3B, และ 80B บนเครื่อง RTX 5090 + 5080 เพื่อหาจุดคุ้มค่าจริงสำหรับรัน AI ในเครื่องปี 2026 นี่คือรุ่นที่เหมาะกับงานแต่ละแบบ — และรุ่นที่ควรเลิกใช้

· 25 นาทีในการอ่าน